
Если вы создаёте изображения в ChatGPT Pro, от того, делаете ли вы это в обычном «Chat» или в «Codex / Work», зависит, какой лимит вы расходуете. На странице тарифов ChatGPT создание изображений в обычном чате Pro указано как «неограниченное». Генерация в Codex расходует лимит Codex / Work, общий с задачами по коду. У Claude нет встроенной способности рисовать фотографии или иллюстрации, но Claude Code может рисовать диаграммы кодом и вызывать внешние API генерации изображений.
Что вы узнаете из этой статьи
- «Неограниченная генерация изображений» в ChatGPT Pro относится к обычному Chat
- Генерация изображений в Codex расходует токены и уменьшает лимит работы
- Изображения ChatGPT и Codex, созданные по одному и тому же запросу
- Действительно ли Claude и Claude Code «не умеют создавать изображения»?
- Как создать пригодное изображение: от подготовки до выбора
- По задачам: где лучше создавать
- Частые вопросы
«Неограниченная генерация изображений» в ChatGPT Pro относится к обычному Chat
На странице тарифов ChatGPT от OpenAI в числе преимуществ Pro указано «Unlimited and faster image creation». Однако на той же странице есть примечание: это предмет ограничений для предотвращения злоупотреблений, поэтому в часы пик и в других ситуациях ограничения могут действовать.
В обычном ChatGPT можно попросить «создай изображение» прямо в диалоге или начать с экрана создания изображений. Как описано в справке OpenAI о функциях изображений, можно также прикрепить существующее изображение и попросить внести изменения. Если вам нужно только изображение, этот путь самый понятный. Если вы будете использовать его в другом инструменте, сохраните файл в полном размере.
Легко перепутать «Chat» и «Work» в ChatGPT. Даже в том же интерфейсе ChatGPT Work делит лимит с Codex. В описании тарифов Work / Codex указано, что лимиты и кредиты у них общие, поэтому «неограниченность» Pro не распространяется на Work и Codex.
Генерация изображений в Codex расходует токены и уменьшает лимит работы
В Codex тоже можно создавать и редактировать изображения, но они учитываются отдельно от ограничений на изображения в обычных чатах ChatGPT. Согласно справке OpenAI по Codex, ограничения на генерацию изображений и время их сброса на стороне ChatGPT к Codex не применяются. В Codex входящие и исходящие изображения обрабатываются как токены, и при использовании по подписке они сначала учитываются в общем лимите вашего тарифа.
Официальный ориентир по среднему расходу: по сравнению с аналогичным ходом без создания изображения генерация изображения расходует лимит примерно в 3–5 раз быстрее. Это зависит от качества и размера, поэтому нельзя перевести в формулу «одно изображение = столько-то сообщений».
Если вы пользователь Pro и входите в ChatGPT через аккаунт, каждая генерация не оплачивается отдельно по API-тарифу. Сначала используется лимит, входящий в подписку; когда он исчерпан, списываются дополнительные кредиты, если они есть, а если их нет, нужно дождаться восстановления лимита. Однако если Codex настроен с API-ключом, взимается плата по API. Текущий остаток и время сброса можно проверить на экране использования Codex.
Если вы поручаете Codex создать изображения для сайта и затем проверить их и исправить код, всё делается в одной задаче. Если же нужно только многократно создавать варианты изображения, можно генерировать их в обычном Chat, сохранять файлы в полном размере и передавать в Codex только выбранные. Ключ — разделять работу в зависимости от того, какой лимит вы используете.
Перед началом смотрите не только на названия экранов, но и на текущий режим и способ аутентификации. Диалог ChatGPT — обычный Chat или Work? Codex — вход через аккаунт ChatGPT или API-ключ? Если перепутать эти два момента, объяснения остатка лимита и оплаты разойдутся, даже если в обоих случаях вы «создали изображение в Pro».
Изображения ChatGPT и Codex, созданные по одному и тому же запросу
Посмотрим на реальные примеры. 30 сентября 2026 г. на этом сайте мы ввели один и тот же англоязычный текст запроса по одному разу. Сторона ChatGPT — обычный Chat на аккаунте Pro, сторона Codex — встроенная функция генерации изображений. Референсные изображения не прикреплялись, после генерации ничего не исправлялось, из нескольких вариантов ничего не выбиралось.
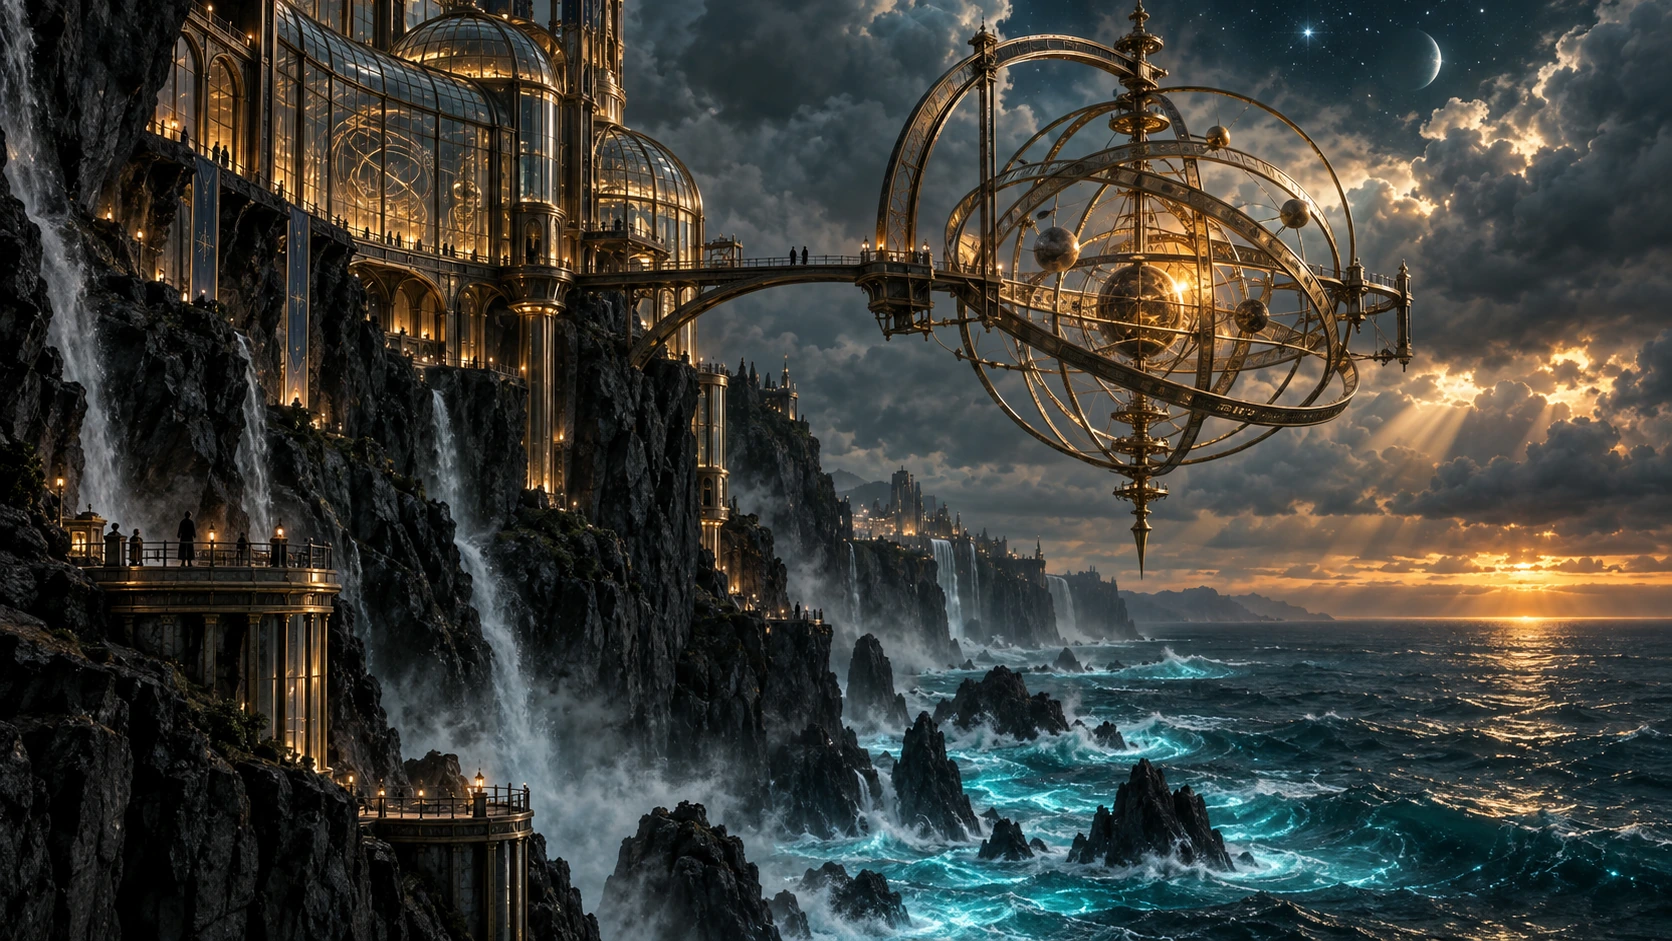
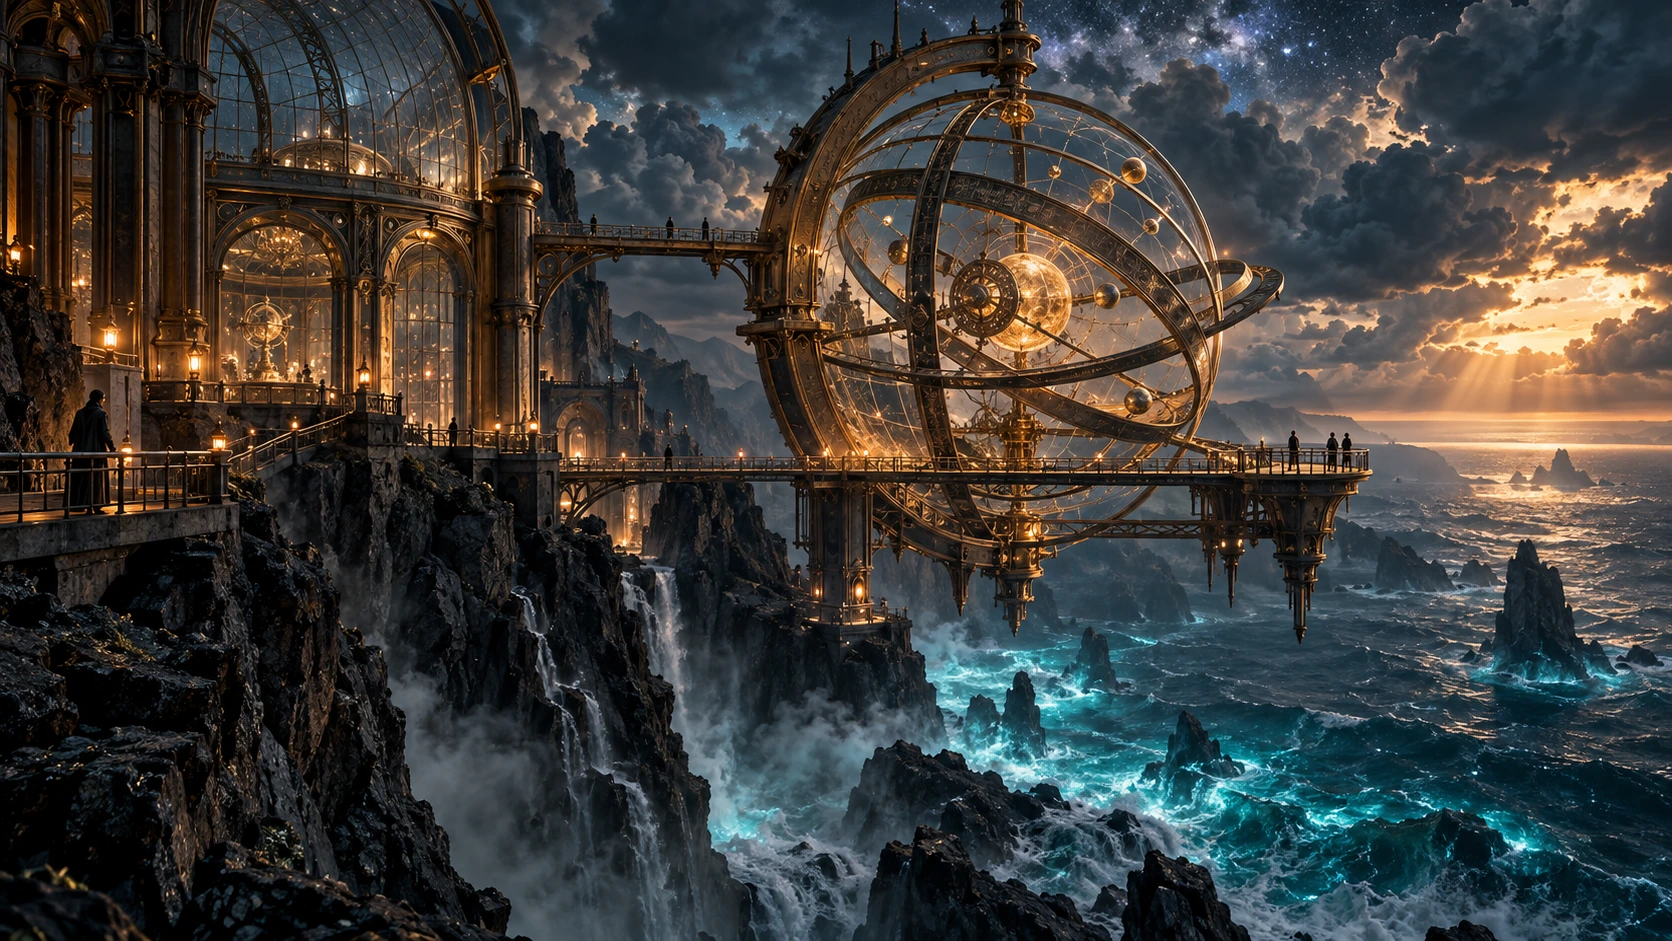
Из публичной документации видно, что в Responses API от OpenAI можно выбрать конфигурацию, в которой модель диалога вызывает инструмент генерации изображений, а изображение создаёт модель GPT Image. Модель на стороне диалога может автоматически переписывать инструкции для изображения. Использует ли обычный Chat в ChatGPT и Codex одну и ту же модель изображений и одни и те же внутренние инструкции, OpenAI не раскрывает.
Посмотреть полный общий промпт
Один горизонтальный концепт-арт. Обсерватория на морском утёсе и гигантская небесная сфера, бирюзовый и янтарный свет, маленькие фигуры людей для ощущения масштаба. В запросе указано не добавлять текст и логотипы.
Use case: stylized-concept. Asset type: editorial sample image for a Japanese article demonstrating AI image generation. Create ONE standalone horizontal 16:9 image, without any typography. Scene: a vast glass-and-brass observatory built into a sheer black volcanic cliff above a storm-lit ocean at twilight. An immense intricate armillary sphere hangs over the sea, its concentric rings catching warm amber light; narrow bridges and a few tiny human silhouettes reveal the colossal scale. Below, turquoise bioluminescent waves strike the rock; above, layered storm clouds break into shafts of light and faint stars. Style: exceptionally polished cinematic concept art with believable architectural detail, atmospheric depth, coherent perspective, restrained deep teal and amber palette, tactile materials, sharp focal point and rich detail that survives reduction to an article card. Composition: one wide coherent scene, focal sphere slightly right of center, clean readable silhouettes. No words, letters, signage, logos, borders, collage, or watermark.
Можно ли по файлу изображения понять, что оно создано ИИ?
OpenAI сообщает, что сгенерированные в поддерживаемых ChatGPT и Codex изображения содержат метаданные происхождения C2PA и невидимый водяной знак SynthID. Наличие зависит от продукта, модели, способа сохранения и времени создания. C2PA — это информация, прикреплённая к файлу, и она может исчезнуть при конвертации или пересохранении; SynthID — отдельный сигнал, встроенный в содержимое изображения. Как сказано в руководстве OpenAI о происхождении контента, отсутствие обнаружения одного из них ещё не означает, что изображение «не создано ИИ».
caBXcaBX — это область, которую спецификация C2PA определяет для хранения манифеста в PNG. Наличие этой области и действительность подписи — разные вещи.Также размещены исходный PNG из ChatGPT и исходный PNG из Codex до конвертации. С помощью инструмента проверки OpenAI можно проверить C2PA и SynthID соответствующих файлов, но для этого изображение нужно отправить в этот сервис. Он показывает только сигналы происхождения и не скажет, какой был промпт, кто пользователь и на каком экране создано изображение.
Если нужно проверить только SynthID, можно воспользоваться SynthID Detector, который Google 7 октября 2026 г. сделал доступным всем (поддерживает изображения, видео и аудио, предоставляется по всему миру на английском языке; проверено 18 октября 2026 г.). Он распознаёт только материалы, созданные компаниями, использующими SynthID, например Google и OpenAI, и это не инструмент для распознавания любого ИИ-контента.
Действительно ли Claude и Claude Code «не умеют создавать изображения»?
Если речь о создании фотографий или иллюстраций моделью генерации изображений, то у современных моделей Claude такой функции нет. В официальной справке Anthropic сказано, что Claude не создаёт фотографии и иллюстрации как инструмент генерации изображений, а в документации по Vision API разделяются способность понимать и анализировать изображения и способность их создавать и редактировать.
Для схем и сравнительных таблиц лучше подходит 01, так как текст и фигуры легче расположить точно. Если нужны фотографии или иллюстрации, выбирайте 03; например, Claude Code вызывает GPT Image API от OpenAI или API изображений Gemini от Google. Claude Code отвечает за формулировку инструкций и сохранение файлов, а сам образ создаёт подключённый сервис. Подключение внешних API и инструментов MCP, а также учётные данные для API изображений нужно подготовить самостоятельно.
Даже при работе через Claude Code оплачиваются вызовы API изображений, а обработка на стороне Claude расходует лимит тарифа или API-токены. При тарифах Claude Pro / Max / Ultra обработка на стороне Claude может укладываться в лимит тарифа, а не оплачиваться отдельно (документация Claude Code о стоимости). API изображений OpenAI тоже считает отдельно генерацию изображений и оплату модели диалога. Например, на странице цен Gemini API от Google по состоянию на 30 сентября 2026 г. вывод одного изображения 1K для Gemini 3.1 Flash Image в платном тарифе Standard стоит 0,067 доллара (входные данные и прочее оплачиваются отдельно).
С другой стороны, встроенная генерация в Codex через аккаунт ChatGPT и прямая генерация в приложении Gemini расходуют лимит соответствующего продукта. Если у вас уже есть квота в рамках подписки и нужно только создать варианты изображения, проще создавать их прямо в этом продукте: не придётся настраивать внешний API и вести два отдельных лимита. Путь через Claude Code подходит, когда вы хотите автоматизировать в одну цепочку создание изображения, встраивание его в код и проверку.
Как создать пригодное изображение: от подготовки до выбора
Какой бы точкой входа вы ни пользовались, если идти в следующем порядке, будет меньше риска наштамповать непригодных изображений или перепутать варианты.
1. Сначала определите, в каком размере оно будет использоваться, и только потом пишите промпт
Изображение, которое в полном размере выглядит детально, при уменьшении до маленькой карточки в списке может потерять главный объект. Если его будут показывать мелко, лучше выделить признаки, по которым его узнают: лицо, причёску, одежду, а не мелкие детали всей фигуры. Хорошо работают указания вроде «квадрат», «от груди и выше», «лицо крупнее», «человек важнее фона». Для широкого hero-изображения заранее продумайте, где будет место под текст и какие части обрежутся.
2. Отделяйте референсы от того, что создаётся заново
Если нужно нарисовать существующего персонажа или продукт, не ограничивайтесь названием: укажите официальную страницу с описанием от правообладателя и URL изображения. Из неё берите только внешние черты; позу, композицию, фон, свет и линии определяйте заново. Перепечатанные чужие изображения не используйте как референс, а также полезно написать, что генерацию нужно остановить, если указанные материалы не открываются. Если сохранить URL референсов, потом можно будет проследить, на чём основано изображение.
При этом ссылка на официальные изображения сама по себе не делает их юридически безопасными. Условия использования референсного материала и права и сходство готового результата нужно проверять отдельно, и человек должен убедиться, что это не просто официальное изображение в другом стиле.
3. Сначала создайте несколько вариантов и решайте, подходят ли они, по оригинальному и показанному размеру
Сначала на небольшом количестве вариантов проверьте стиль, передачу черт и отделение от фона, и только потом увеличивайте число изображений. Это помогает не перепутать соответствие между изображением и сюжетом. Если просите несколько изображений, укажите «по одному изображению на сюжет» и «отдельными файлами». Без этого несколько сюжетов может собраться в один коллаж.
Сохраняйте не скриншот экрана, а файл результата в полном размере. В полном размере проверяйте руки, одежду и случайно попавшие текст или логотипы, а в реальном размере показа смотрите, узнаётся ли главный объект. Если для каждого файла записать в одной строке имя, место сохранения, URL референса и причину принятия или отказа, то при передаче другому инструменту или человеку не возникнет путаницы.
Если в первом варианте фон хороший, но лицо слишком мелкое и на карточке его не разобрать, в следующий раз не меняйте стиль целиком, а попросите точечно: «фон оставить, лицо переместить в верхнюю половину кадра». Если лицо читается, но черты одежды пропали, немного расширьте кадр до груди и выше. Если менять одну-две вещи, видно, какая инструкция сработала. Когда изображение готово, проверьте его в тех размерах, в каких оно будет использоваться: в карточке списка, в тексте статьи, в превью при публикации в соцсетях.
Даже если указать «без текста», текст может всё равно появиться, например внизу изображения окажется полоса с именем. Иногда полосу можно обрезать и использовать остальное, но если выбирать изображение, глядя только на сюжет, это пропустишь. Проверяйте края изображения в полном размере.
«Назначение: небольшая карточка в списке. Квадрат, исследовательский робот крупно от груди и выше. Композиция, в которой черты головы и лица узнаются даже при уменьшении. Фон — свет и атмосфера, напоминающие ночную обсерваторию, но не заметнее главного объекта. Без текста, логотипов и водяных знаков. Сначала выведите один кадр отдельным файлом и не тиражируйте, пока не подтвердите выбор.»
4. При передаче в другой инструмент передавайте вместе изображение и обоснование
Когда вы передаёте в Codex или Claude Code изображение, созданное в ChatGPT, для встраивания, если отдать только файл, станет неясно, какая версия выбрана. Добавьте короткую заметку: имя принятого файла, страница, где он используется, назначение, URL референсов и признаки, которые должны сохраниться при уменьшении. Например: «Принято: portrait-final.png / Назначение: квадрат для карточки в списке / Референс: официальная страница настроек / Отклонено: portrait-02.png (лицо не читается в мелком размере)».
С такой заметкой не получится по ошибке подтянуть не то изображение или пересоздать то же самое. Если вы делитесь референсными изображениями, проверьте, можно ли их передавать дальше, а перед публикацией убедитесь, что подписи и альтернативный текст соответствуют реальной картинке.
По задачам: где лучше создавать
При Pro первый выбор — обычный чат ChatGPT. Сохраняйте результаты и передавайте в рабочую среду только нужные варианты.
В Codex можно в одну цепочку создать, сохранить, встроить и проверить на экране. Сначала проверьте остаток общего лимита.
Подходят HTML и SVG в Claude Code или Claude Design. Если нужны фотографии, подключите внешнюю модель изображений.
Если хотите сравнить стиль и цены самих генераторов изображений, см. Сравнение инструментов генерации изображений. Если хотите начать с основ промптов, см. Введение в генерацию изображений, а процесс создания дизайна подробно описан в обзоре Claude Design. Критерий решения в этой статье — точка входа, лимит использования и тип того, что вы хотите создать, а не рейтинг инструментов.
Итоги
В обычном чате ChatGPT Pro создание изображений в тарифах указано как «неограниченное» (при этом действуют ограничения для предотвращения злоупотреблений). Генерация в Codex / Work расходует общий лимит работы и тратит больше, чем такой же по объёму диалог без изображений. Claude не модель, которая напрямую рисует фотографии или иллюстрации, но в Claude Code можно создавать схемы и дизайны и подключать внешние API изображений. Выбрав точку входа, сначала задайте назначение и размер показа, а решение о принятии принимайте по оригиналу и по реальному размеру показа.
Частые вопросы
Если у меня ChatGPT Pro, то изображения в Codex тоже неограниченны?
Нет. «Неограниченное создание изображений» для Pro на странице тарифов OpenAI относится к обычному ChatGPT Chat. Генерация изображений в Codex / Work расходует общий лимит использования. Ограничения обычного Chat на изображения к Codex тоже не применяются напрямую.
Сколько токенов уходит на одно изображение в Codex?
Это не фиксированная величина. Она зависит от текста инструкции, наличия референсных изображений, размера и качества выводимого изображения. «В среднем в 3–5 раз» по данным OpenAI — это сравнение с аналогичным ходом без изображения; это не цена одного изображения и не число оставшихся.
Если Claude Code может вывести PNG, значит, и Claude может генерировать изображения?
Это зависит от способа вывода. Если PNG нарисован через SVG или программу, можно сказать, что файл изображения создал Claude Code. Однако сама модель Claude не стала моделью генерации фотографий или иллюстраций. Если изображение создано через внешний API, его сгенерировала подключённая модель.


