
Si tienes ChatGPT Pro y quieres crear una imagen, comprueba primero si estás en un chat normal o en Codex/Work. Incluso con la misma suscripción, usan cupos distintos. La página de precios de ChatGPT califica de «ilimitada» la creación de imágenes en los chats normales de Pro. En Codex, en cambio, las imágenes consumen el cupo de Codex/Work, compartido con la programación y otras tareas. Claude funciona de otra manera: el modelo Claude no genera por sí mismo fotografías ni ilustraciones, aunque Claude Code puede dibujar diagramas mediante código o llamar a una herramienta externa de generación de imágenes.
Contenido de este artículo
- La creación «ilimitada» en ChatGPT Pro se refiere al chat normal
- Las imágenes de Codex consumen tokens y el cupo de trabajo
- Imágenes de ChatGPT y Codex creadas con la misma petición
- ¿Pueden Claude y Claude Code crear imágenes?
- Cómo crear imágenes utilizables: desde el encargo hasta la selección
- ¿Qué herramienta conviene para cada tarea?
- Preguntas frecuentes
La creación «ilimitada» en ChatGPT Pro se refiere al chat normal
La página de precios de ChatGPT de OpenAI indica que Pro ofrece una creación de imágenes «ilimitada y más rápida». «Ilimitada» es la expresión de esa página: no equivale a una cifra diaria fija publicada. La misma página advierte que está sujeta a límites para prevenir abusos. No la interpretes como una garantía de poder generar cientos de imágenes de forma continua todos los días.
En un chat normal de ChatGPT puedes pedir una imagen durante la conversación o empezar desde la pantalla de creación de imágenes. La guía de OpenAI sobre las imágenes en ChatGPT también explica cómo subir una imagen existente y solicitar cambios. Si solo necesitas una imagen, este suele ser el punto de partida más sencillo. Si vas a usarla en otra herramienta de producción, guarda el archivo generado a su resolución original.
Una confusión habitual es la diferencia entre Chat y Work dentro de ChatGPT. Aunque estés en ChatGPT, Work comparte su cupo con Codex. La palabra «ilimitada» aplicada a las imágenes de Pro no se puede trasladar sin más a las tareas de Work o Codex. La documentación de precios de Work/Codex de OpenAI indica expresamente que ambos comparten límites de uso y créditos.
Las imágenes de Codex consumen tokens y el cupo de trabajo
Codex puede generar y editar imágenes, pero no usa el límite de imágenes que se muestra para los chats normales de ChatGPT. La página de ayuda de OpenAI sobre Codex explica que los límites y plazos de restablecimiento de la generación de imágenes mostrados en ChatGPT no se aplican a Codex. En Codex, las imágenes de entrada y salida se procesan como tokens. Si inicias sesión con una suscripción, el consumo se descuenta primero del cupo general del plan.
Según el promedio que publica OpenAI, generar una imagen consume el cupo entre 3 y 5 veces más rápido que un turno parecido sin imagen. Como la calidad y el tamaño alteran el consumo, no existe una equivalencia fija de «una imagen = X mensajes».
Consumir tokens no implica necesariamente un cobro adicional. Si tienes Pro e inicias sesión con tu cuenta de ChatGPT, cada imagen no genera por sí sola una factura de API. Primero utiliza el cupo incluido en la suscripción. Al agotarlo, se pueden usar créditos adicionales si están disponibles; si no, toca esperar a que se renueve. Si accedes a Codex con una clave API, se aplican los precios de la API, así que no basta con tener Pro para afirmar que no habrá cargos adicionales: comprueba cómo has iniciado sesión. La pantalla de uso de Codex muestra el cupo disponible y cuándo se restablece.
Por ejemplo, puedes pedir a Codex que cree una imagen para un sitio web, la examine y actualice el código del sitio sin salir del mismo flujo. Si solo estás explorando candidatos, también puedes generarlos en un chat normal, guardar los archivos originales y pasar a Codex únicamente la imagen elegida. Esta segunda vía no tiene por qué ser más rápida ni barata, pero te permite decidir de forma consciente qué cupo consume cada parte del trabajo.
Antes de empezar, comprueba el modo actual y el método de autenticación, no solo el nombre que aparece arriba. ¿La conversación de ChatGPT es un chat normal o Work? ¿Codex usa tu cuenta de ChatGPT o una clave API? Confundir esas dos cosas cambia la explicación del saldo y de los posibles cargos, aunque ambas experiencias parezcan «crear imágenes con Pro». Anota la fecha, el punto de entrada, el plan y el ajuste de calidad de imagen para poder reconstruir cómo obtuviste el resultado.
Imágenes de ChatGPT y Codex creadas con la misma petición
Veamos dos ejemplos. El 30 de septiembre de 2026, este sitio introdujo el mismo prompt en inglés una vez en cada producto. La imagen de ChatGPT se creó en un chat normal con una cuenta Pro; la de Codex, con su función integrada de generación de imágenes. No adjuntamos imágenes de referencia, no retocamos los resultados y no elegimos entre varias propuestas.
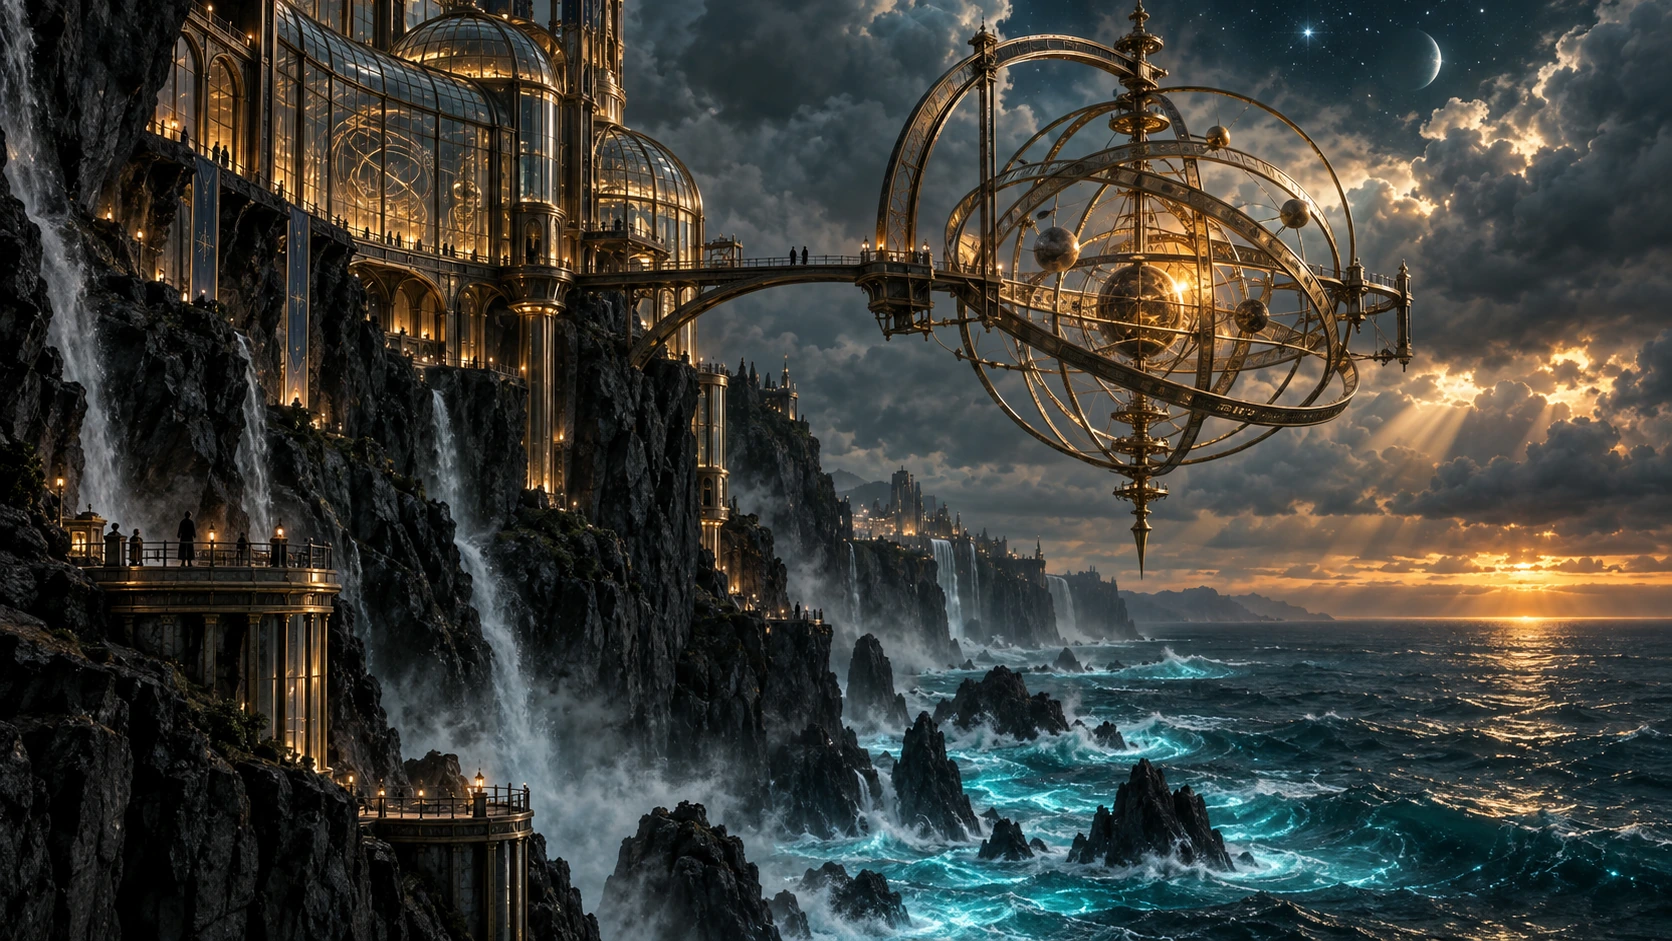
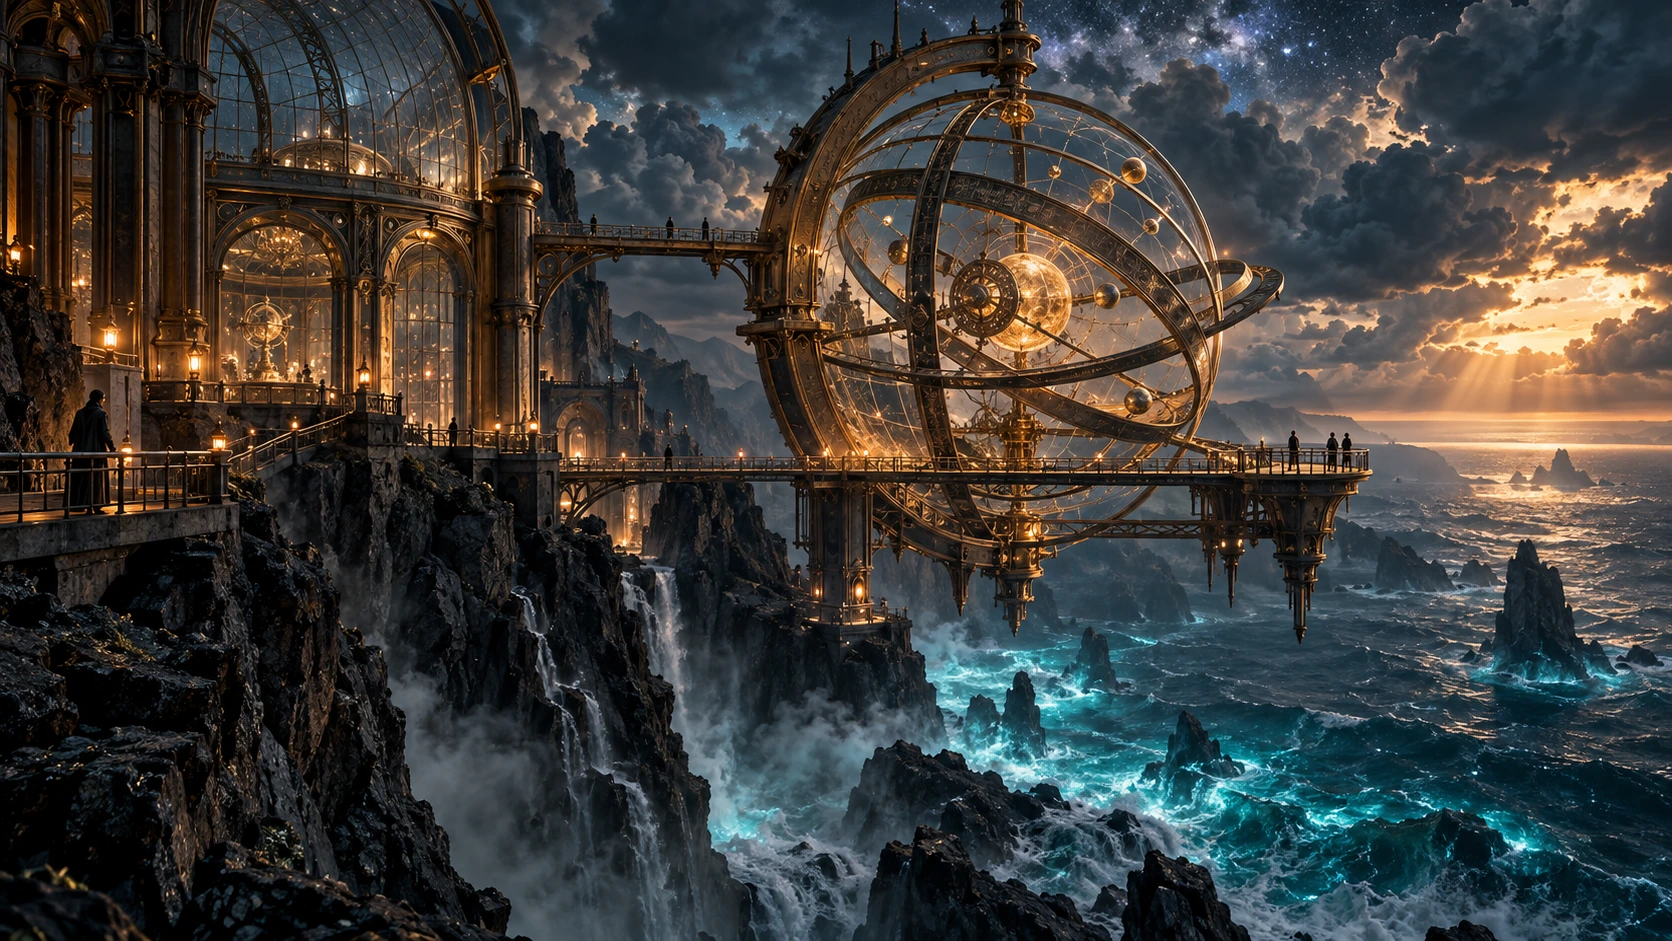
La documentación pública permite describir una posible arquitectura: en la API Responses de OpenAI, un modelo conversacional puede llamar a una herramienta de generación, que crea la imagen con un modelo GPT Image. El modelo conversacional puede reformular el prompt y la API puede mostrar esa versión revisada. Sin embargo, ni la información pública ni estas interfaces permiten saber si ChatGPT normal y Codex usaron aquí el mismo modelo de imagen o el mismo prompt interno. La similitud visual por sí sola no revela cómo se generaron internamente.
Ver el prompt completo compartido
Pedimos una única imagen panorámica de arte conceptual: un observatorio y una esfera armilar gigantesca sobre un acantilado junto al mar, luces verdes azuladas y ámbar, personas diminutas para transmitir la escala y ningún texto ni logotipo.
Use case: stylized-concept. Asset type: editorial sample image for a Japanese article demonstrating AI image generation. Create ONE standalone horizontal 16:9 image, without any typography. Scene: a vast glass-and-brass observatory built into a sheer black volcanic cliff above a storm-lit ocean at twilight. An immense intricate armillary sphere hangs over the sea, its concentric rings catching warm amber light; narrow bridges and a few tiny human silhouettes reveal the colossal scale. Below, turquoise bioluminescent waves strike the rock; above, layered storm clouds break into shafts of light and faint stars. Style: exceptionally polished cinematic concept art with believable architectural detail, atmospheric depth, coherent perspective, restrained deep teal and amber palette, tactile materials, sharp focal point and rich detail that survives reduction to an article card. Composition: one wide coherent scene, focal sphere slightly right of center, clean readable silhouettes. No words, letters, signage, logos, borders, collage, or watermark.
¿Puede un archivo revelar que lo creó una IA?
OpenAI señala que las imágenes compatibles generadas en ChatGPT y Codex pueden llevar metadatos de procedencia C2PA y una marca de agua invisible SynthID. La presencia de estas señales depende del producto, el modelo, la forma de guardar el archivo y la fecha de creación. C2PA almacena información adjunta al archivo que puede perderse al convertirlo o volver a guardarlo. SynthID es otra señal, integrada en el contenido visual. La guía de OpenAI sobre la procedencia del contenido advierte además que no detectar ninguna señal no demuestra que la imagen no se haya creado con IA.
caBX.caBX es el área que especifica C2PA para almacenar un manifiesto en PNG. Que exista esa área no demuestra por sí solo que la firma sea válida; aquí no verificamos su autenticidad.Para quien quiera investigar, también ofrecemos el PNG original de ChatGPT y el PNG original de Codex. La herramienta de verificación de OpenAI puede comprobar señales C2PA y SynthID en archivos compatibles, pero para usarla hay que enviar la imagen a ese servicio. Detectar una señal indicaría información de procedencia compatible; no demostraría cuál fue el prompt, quién fue el usuario ni si la imagen salió de un chat normal o de Codex. Las etiquetas sobre la vía de generación se basan en los registros de trabajo de este sitio.
¿Pueden Claude y Claude Code crear imágenes?
Si por «crear imágenes» entendemos generar fotografías o ilustraciones directamente con un modelo de imagen, los modelos Claude actuales no ofrecen esa función. La página de ayuda oficial de Anthropic indica que Claude no crea fotos ni ilustraciones como una herramienta de generación de imágenes. Su documentación de Vision para la API también distingue entre comprender y analizar imágenes, y generarlas o editarlas.
Los diagramas y las tablas comparativas permiten colocar texto y formas con precisión. Pero un PNG dibujado mediante código no significa que el modelo Claude haya generado una fotografía. Para crear fotos o ilustraciones, la vía 03 podría consistir en llamar desde Claude Code a la API GPT Image de OpenAI o a la API de imágenes Gemini de Google. Claude Code puede organizar las instrucciones y guardar el archivo, pero el proveedor conectado genera la imagen. El usuario debe configurar la API externa o la herramienta MCP y aportar las credenciales de la API de imágenes. Claude Code no obtiene automáticamente acceso a estas API como función predeterminada.
Si comparas la misma API de imágenes, el mismo modelo y la misma resolución, pasar por Claude Code no elimina el cargo de la API de imágenes; el procesamiento en Claude también consume cupo o tokens de API. Por tanto, el consumo total puede aumentar frente a una llamada directa a la API de imágenes. Con una suscripción Claude Pro o Max, sin embargo, el trabajo en Claude puede caber dentro del cupo incluido sin generar una factura aparte. La documentación de costes de Claude Code distingue el uso con suscripción de la facturación por API. La documentación de la API de imágenes de OpenAI contabiliza por separado la generación de imágenes y el modelo conversacional. Como ejemplo concreto, la página de precios de la API de Gemini de Google indicaba el 30 de septiembre de 2026 un equivalente de 0,067 dólares por imagen de salida de 1K con Gemini 3.1 Flash Image en el nivel Standard de pago; la entrada y otros cargos van aparte. Al llamarla desde Claude Code seguirías pagando ese cargo de la API de imágenes y, además, consumirías capacidad de Claude.
En cambio, la generación integrada de Codex cuando accedes con una cuenta de ChatGPT y la generación directa en la aplicación Gemini se rigen por los cupos de sus respectivos productos. No se puede comparar el precio por imagen de una API de pago por uso con esos cupos y concluir que «Claude siempre cuesta X más por imagen». Las imágenes de Codex consumen el cupo compartido de Work/Codex, mientras que la autenticación mediante clave API aplica precios de API. Si ya tienes un cupo incluido y solo necesitas ideas visuales, generar directamente en ese producto puede ahorrarte la configuración de una API externa y la gestión de dos cupos. Claude Code resulta útil cuando quieres automatizar en un mismo flujo la generación, la integración en el código y la revisión de las imágenes.
Cómo crear imágenes utilizables: desde el encargo hasta la selección
Las siguientes notas de campo proceden de otro proyecto en el que la persona responsable de este sitio generó y revisó imágenes. Hemos convertido lo aprendido en un flujo reutilizable. Los registros no incluyen la versión del modelo ni la fecha de ese trabajo, por lo que no constituyen una prueba de rendimiento de un modelo concreto ni demuestran reproducibilidad. Lo valioso es el orden de trabajo y los fallos observados, no el tema de las imágenes ni una clasificación de los resultados.
1. Decide el tamaño de visualización antes de escribir el prompt
Una imagen puede verse detallada a resolución completa, pero perder al protagonista al reducirla a una tarjeta pequeña. Para esos usos, agranda los rasgos que permiten reconocerlo —cara, peinado o ropa— en vez de confiar en detalles del cuerpo entero. Ayudan indicaciones como «formato cuadrado», «de pecho hacia arriba», «cara prominente» o «dar prioridad al protagonista sobre el fondo». En una imagen de cabecera horizontal, considera de antemano el espacio para el texto superpuesto y dónde se recortará.
2. Separa las referencias de lo que quieres crear
Si vas a representar un personaje o producto existente, no supongas que el modelo lo conoce por el nombre. Aporta una página oficial de descripción y la URL de una imagen. Usa esas fuentes para comprobar los rasgos visibles, y define de nuevo la pose, la composición, el fondo, la iluminación y el trazo. Excluye como referencias las imágenes republicadas por terceros e indica a la herramienta que se detenga si no puede abrir las fuentes especificadas. Guarda sus URL en las notas de producción para poder rastrear después en qué te basaste.
Pero usar una imagen oficial como referencia no convierte automáticamente el resultado en seguro para su uso. Comprueba por separado las condiciones de uso del material de referencia y los derechos y la similitud de la imagen terminada. Una persona debe revisar que el resultado no sea simplemente una imagen oficial con otro estilo.
3. Genera unas pocas y evalúalas a tamaño completo y real
Empieza con pocos candidatos para revisar el estilo, los rasgos distintivos y la separación del protagonista respecto del fondo. Aumenta el lote solo después, para que sea más fácil asociar cada imagen con su motivo. Si pides varias, especifica «una imagen por motivo» y «cada una en un archivo independiente que se pueda guardar». Sin esa instrucción, varios motivos pueden acabar reunidos en un solo collage.
Siempre que puedas, guarda el archivo a resolución original, no una captura de pantalla. A tamaño completo, revisa manos, ropa y texto o logotipos inesperados; al tamaño de uso, comprueba que se reconozca al protagonista. Anota el nombre y la ubicación del archivo, la URL de referencia y una razón breve para aceptar o descartar cada imagen. Así se reducen los errores al pasar el trabajo a otra herramienta o persona.
Imagina que el primer candidato tiene un buen fondo, pero la cara es demasiado pequeña para reconocerse en una tarjeta. En lugar de cambiar todo el estilo, pide conservar la dirección del fondo y situar la cara en la mitad superior. Si la cara se distingue bien pero se pierde la ropa, amplía un poco el encuadre de pecho hacia arriba. Modificar solo una o dos cosas cada vez permite apreciar qué instrucción influyó en el resultado. Al terminar, revísalo otra vez con los tamaños reales de las tarjetas, el cuerpo del artículo y las vistas previas en redes sociales.
En un intento registrado se pidieron cuatro imágenes a la vez y llegaron como archivos separados. Sin embargo, cada una tenía abajo una franja blanca con un nombre, contra la instrucción de «sin texto». Se pudieron usar tras recortar la franja y dejar un cuadrado. Si se hubiera mirado solo el motivo principal, el texto intruso habría pasado inadvertido. No se registraron el nombre ni la versión del modelo ni la fecha del intento. Una sola prueba no permite calcular una tasa de fallos ni comparar la calidad de la generación por lotes.
«La imagen se usará en una tarjeta pequeña. Crea un cuadrado con un robot explorador ficticio, grande y de pecho hacia arriba. La cara y los rasgos de la cabeza deben reconocerse incluso al reducirlo. Sugiere con luces y ambiente un observatorio nocturno al fondo, sin que destaque más que el robot. No incluyas texto, logotipos ni marcas de agua. Entrega primero un solo archivo de imagen independiente; no crees un lote hasta que apruebe el resultado».
En las notas de campo, guardar manualmente a resolución original las imágenes creadas en el navegador funcionó de forma fiable. La automatización del navegador en ese entorno concreto también consumía el cupo de su herramienta y no permitió confirmar dónde se guardaban las descargas. Se trata de una observación de ese entorno, no de una limitación de todos los navegadores o servicios. Tampoco medimos afirmaciones como «generar cuatro a la vez no reduce la calidad». Empezar con pocas facilita la inspección y la asociación entre imagen y motivo.
4. Entrega la imagen junto con su contexto
Si creas una imagen en ChatGPT y pides a Codex o Claude Code que la integre, entregar solo un archivo y decir «usa esta imagen» no aclara cuál de varios candidatos es el elegido. Acompáñalo de una nota breve con el nombre del archivo seleccionado, la página de destino, el uso previsto, la URL de referencia y los rasgos que deben conservarse al reducirla. Por ejemplo: «Elegida: portrait-final.png / uso: tarjeta cuadrada / referencia: página oficial del personaje / descartada: portrait-02.png (cara ilegible en pequeño)».
Aunque la generación y la implementación ocurran en herramientas distintas, ese registro reduce el riesgo de incorporar el candidato equivocado o repetir una generación innecesaria. Si guardas y compartes una imagen de referencia por tu cuenta, comprueba si tienes permiso para redistribuirla. Antes de publicar el resultado en un artículo o producto, verifica que el pie de foto y el texto alternativo describan lo que realmente muestra.
¿Qué herramienta conviene para cada tarea?
Para quien tiene Pro, el chat normal de ChatGPT suele ser un buen primer paso. Guarda los resultados y lleva al entorno de producción solo los candidatos necesarios.
Codex permite generar, guardar, integrar y revisar imágenes en un mismo flujo. Comprueba primero cuánto queda del cupo compartido.
HTML o SVG creados con Claude Code y Claude Design pueden servir. Si necesitas una fotografía, conecta un modelo externo de imágenes.
Si quieres comparar estilos y precios de los modelos de imagen, consulta nuestra comparación de herramientas de generación de imágenes. Si estás empezando con los prompts, lee la guía de iniciación a la generación de imágenes con IA; y si te interesa el proceso de diseño, consulta la guía de Claude Design. Este artículo se centra en los puntos de entrada, los cupos y los tipos de recurso producido, no en clasificar las herramientas.
Conclusiones
Según la página de precios, ChatGPT Pro ofrece creación «ilimitada» de imágenes en el chat normal, con restricciones de uso para prevenir abusos. En Codex/Work, las imágenes consumen un cupo de trabajo compartido y gastan más que un turno comparable sin imágenes. Claude no genera fotografías ni ilustraciones por sí mismo, pero Claude Code puede crear diagramas y diseños y conectarse a herramientas externas. Elige dónde generar, define la finalidad y el tamaño de visualización y revisa los candidatos tanto a resolución original como al tamaño real de uso.
Preguntas frecuentes
¿ChatGPT Pro me permite crear imágenes ilimitadas en Codex?
No. La «creación ilimitada de imágenes» en la página de precios de Pro describe el chat normal de ChatGPT. Las imágenes de Codex/Work consumen el cupo general compartido. Tampoco se traslada a Codex el límite de imágenes que aparece en el chat normal.
¿Cuántos tokens consume una imagen en Codex?
No hay una cifra fija. Depende del prompt, las imágenes de referencia, el tamaño y la calidad de salida. El promedio de OpenAI de «entre 3 y 5 veces más rápido» compara la generación de imágenes con un turno parecido sin imágenes. No es un precio fijo por imagen ni una estimación del número de generaciones restantes.
Si Claude Code produce un PNG, ¿significa que Claude puede generar imágenes?
Depende de cómo se creó el archivo. Si es un PNG dibujado con SVG o código, Claude Code creó un archivo visual, pero el modelo Claude no se convirtió en un generador de fotos o ilustraciones. Si procede de una API externa, quien generó la imagen fue el proveedor conectado.


